
Appearance
Jackie 的身高,我改了兩次
一場教會的戲拍了兩版之後,我發現模型不看劇本,它看你給它的那張圖
作者:瑞導 日期:2026 年 9 月 28 日
我在 RunPod 上自架 MiniMax H3,拍一部十集的橫屏 AI 網路劇《矽谷之戀》。 第一集第五場:男主角 Richard 剛被裁員,被學長拉去華人教會,禮拜後在聚會廳認識三個女生。
劇本上是這樣:Tony 介紹 Linda、Jenny 和 Jackie,Richard 客氣地笑,Jackie 一直沒說話,最後對他淺淺一笑。 很簡單的一場戲。
這是第一版:
粗剪 v1(9 月 26 日)。不調色、不上字幕的工作版。
看完我寫下的筆記是:介紹像點名、空間忽大忽小、遠景的臉慘不忍睹、三個女生不像本人。
我的第一個反應是換模型。花了一個上午查 Seedance、Kling、Veo 最新的狀況,最後得出一個有點丟臉的結論: 這些問題換哪個模型都會發生。 這就像拍壞了一場戲,第一個念頭是換一台攝影機 —— 但攝影機沒有錯,是我擺的東西不對。
兩天後的第二版:
粗剪 v2(9 月 28 日)。一樣不調色、不上字幕。
中間改了分鏡,但我花最多時間的地方很無聊:把每一張參考圖重做,而且做到對為止。
先講一個前提:H3 吃的是一張「板」
H3 有一個模式叫 Ref2VA,你可以餵它幾張參考圖:角色的臉、衣服,還有一張場景圖 —— 我們叫它「板」, 就是這顆鏡頭一開始的畫面:房間長什麼樣、誰站在哪裡。
我原本以為板只是在交代房間。拍完兩輪我才搞懂:
板上站的是誰,模型就讓誰演。板上的人長什麼樣,影片裡的人就長什麼樣。
提示詞管的是「接下來發生什麼」。板管的是「誰、在哪、長怎樣、多高」。 第一版我把九成力氣放在提示詞,問題卻九成出在板上。
下面是這兩天我講過的筆記,和它們背後真正要改的地方。
「遠景生成的人臉慘不忍睹」
聚會廳的全景裡,三個女生的臉在畫面上只有二、三十個像素。H3 畫出來的是三個陌生人。
我一開始的想法是:那就在提示詞裡把臉寫得更清楚。寫了,沒用。又接了她們的臉部參考圖,還是沒用。
後來查到 MiniMax 自己承認過:臉小到一定程度,模型就是畫不出特定的人,這是系統級的限制。 不是我寫得不夠好,是那幾十個像素裝不下一張認得出來的臉。
所以不要跟它拔河。 我改成在「生板」的時候就把遠景的人做對: 把那一小區放大,讓圖像模型換臉、換體態,再縮回去貼上。 H3 拿到一張「本來就是她們」的板,就不用靠自己去猜。
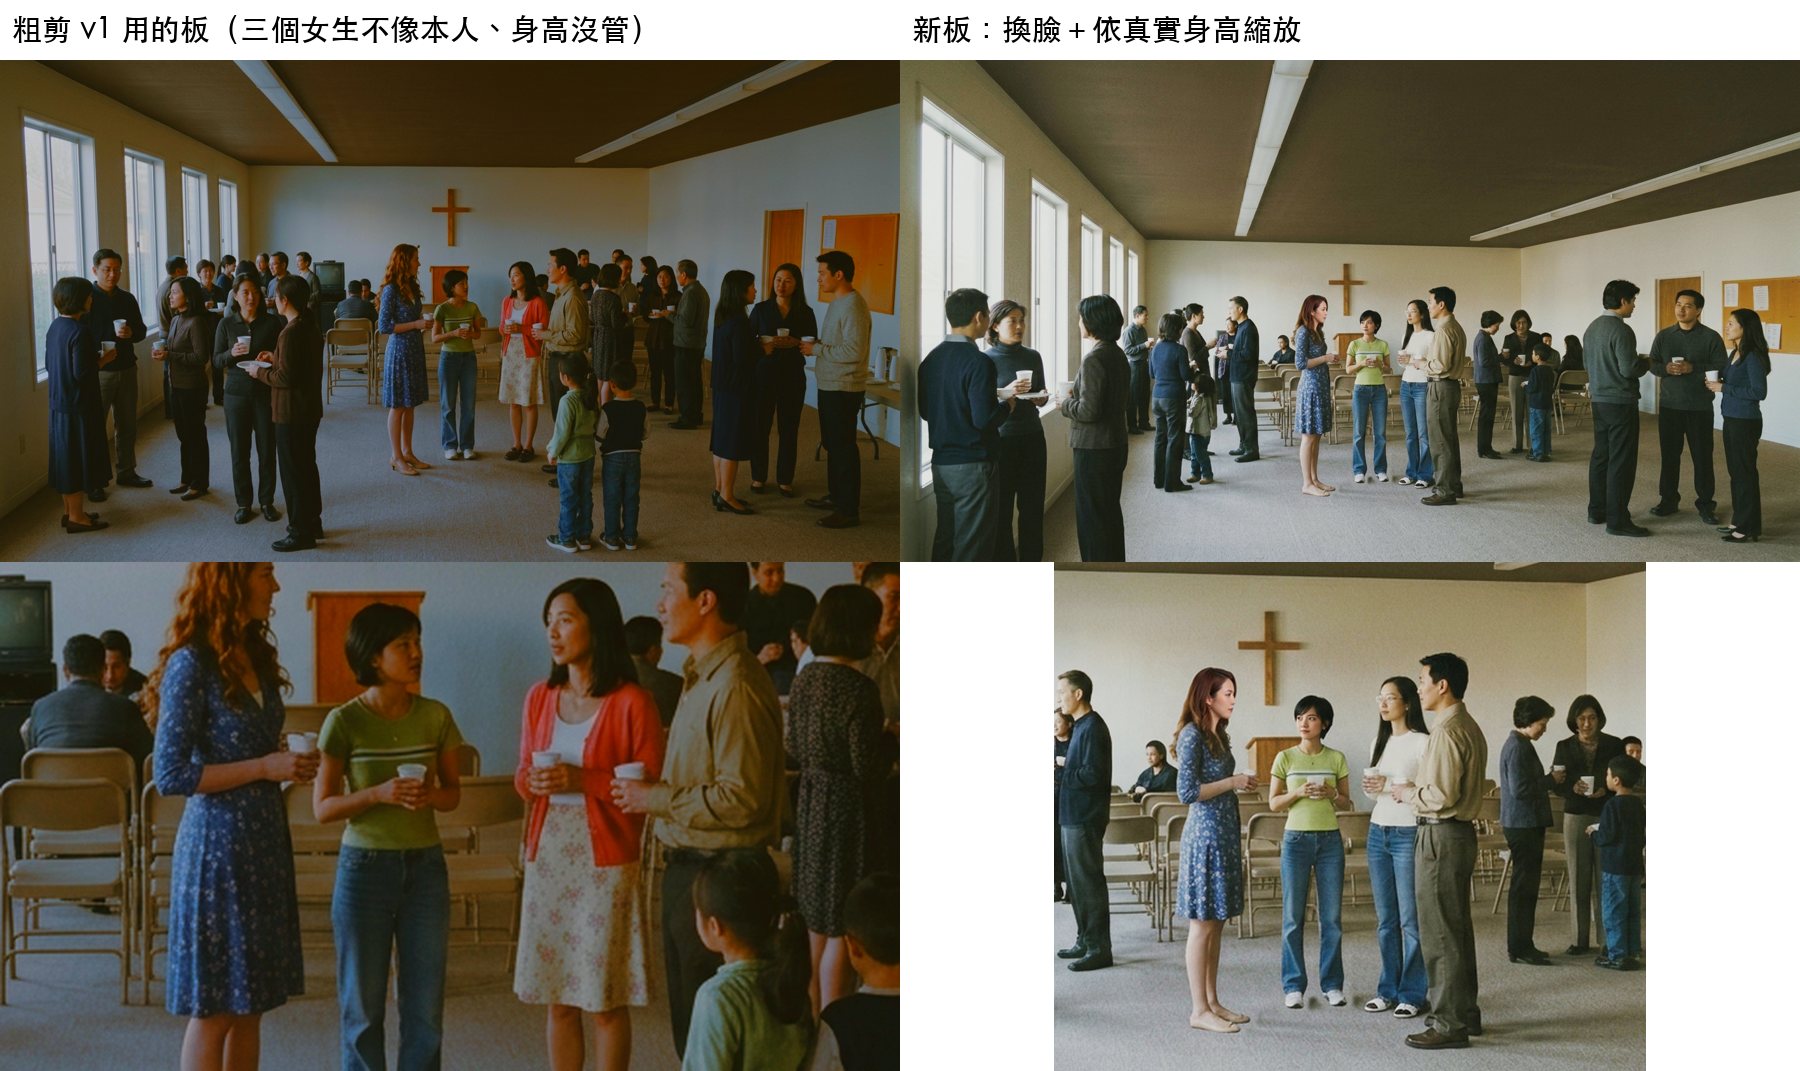
左:v1 用的板。右:換臉、依真實身高縮放之後。遠景還是認不出五官,但至少不會「看起來是別人」。
「Jenny 比例上太高了」
換完臉,新的問題來了:Jenny 比所有人都高,包括 Tony。
我跟圖像模型說:「讓她的頭頂降到 Tony 眉毛的高度。」 Gemini 很有禮貌地回了一張圖,Jenny 矮了大概一公分。
⭐ 這是我這兩天最實用的一課:圖像模型幾乎不聽尺寸的指令。 它聽得懂「換一件衣服」「拿掉這個人」,聽不懂「矮五公分」。
最後可靠的做法很土:
① 叫模型把她「摳」出來(其他地方全塗成綠色)
② 程式依真實身高算縮放比例 —— Jenny 171、Jackie 167、Linda 158 公分
③ 腳踩在原地,等比縮小,貼回去
比例這種事,交給會算數的東西。
「506 的 Jackie 比 Jenny 高,要調整」
然後我改了。
「506 Jackie 還是太高」
然後我又改了一次。
第一次我讓她只比 Jenny 矮一點點(畫面上低 10 個像素),因為照身高算,她只比 Jenny 矮 4 公分。 但 Jackie 站得離鏡頭最近,透視會讓她看起來比實際高,H3 生成時又順手把她拉高了一點。 第二次直接降了半顆頭,才終於看起來對。
真實身高是一回事,畫面上看起來的高度是另一回事。 觀眾只看得到後面那個。
「不要用點名的方式來拍」
第一版的介紹是 Tony 站在中間,一個一個指著說「這是 Linda、這是 Jenny」。 很像開學第一天。
我要的是 Richard 的眼睛:他走過去,先看到三個女生的背影,她們轉過來,然後鏡頭慢慢推近每一個人。
這一次我沒有直接寫提示詞,而是先回到平面圖:
平面圖(牆、窗、椅子、每個人站哪、每個機位在哪)
  → Blender 灰模(同一份座標,每個機位算一張圖)
    → 圖像模型把灰模變成寫實的板
      → H3 拿板當第一格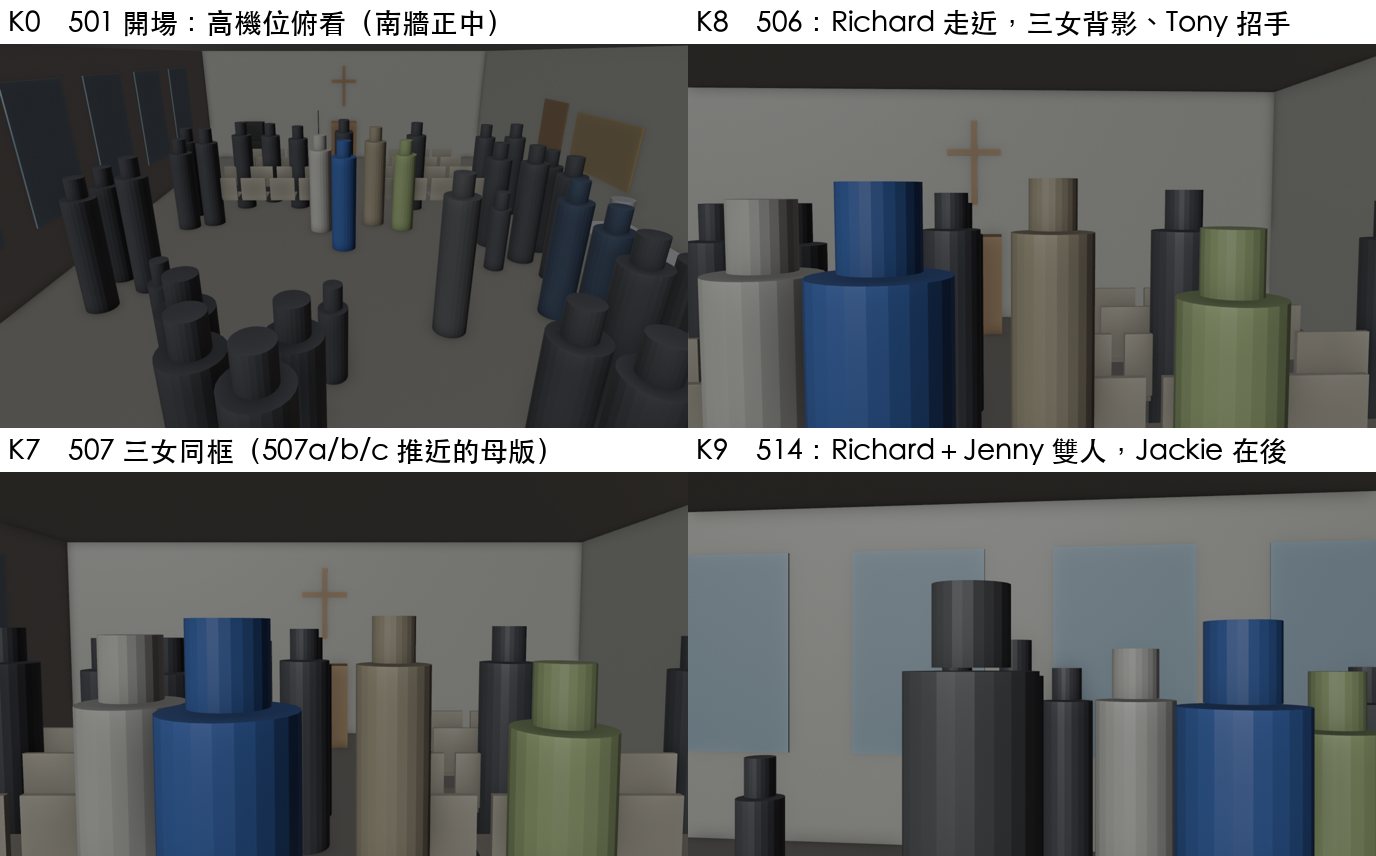
灰模裡每一根圓柱就是一個人,顏色是那個角色的衣服。
灰模很醜,但它讓我在花任何算力之前,就看到「這個機位 Jackie 會被 Jenny 整個擋住」。 在平面圖上挪一個座標是幾秒鐘的事;等 H3 拍完才發現,是一次開機、一次算圖、一次看片。
⭐ 八月我寫過〈我把上一篇刪掉的那一步,加了回來〉,講的是算圖之前先生分鏡圖。 這一場讓我確定:板就是分鏡圖,只是它同時也是模型的輸入。
「image-2 較自然」
有了灰模,下一步是把它變成寫實的板。這次我沒有只用平常的 Gemini, 而是拿同一組輸入 —— 灰模、四張臉、三張服裝圖 —— 讓五個圖像模型各生一次:
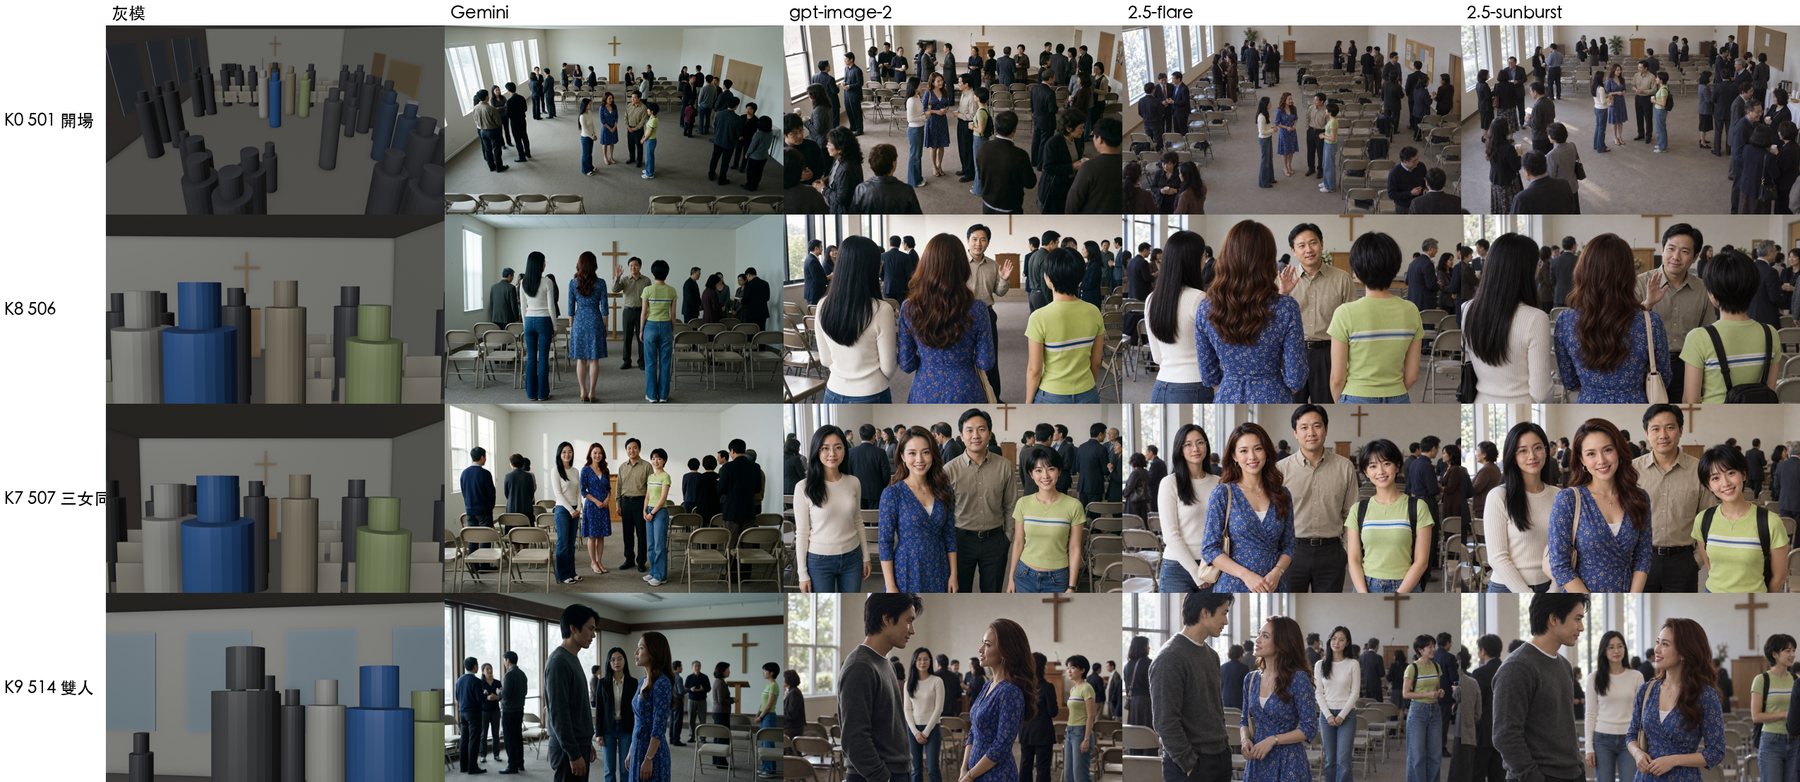
每一列是一個機位,每一欄是一個模型。
差別比我預期的大:
Gemini(flash、Nano Banana Pro)  鏡頭會自己往後退,灰模裡的近景守不住
GPT(image-2、2.5 flare、2.5 sunburst) 照灰模的近景走,臉也最像本人
GPT 的三個裡,最新的 2.5 有一個可愛的毛病:我餵了一張三個女生的服裝示意圖, 圖裡的人背著包包 —— 2.5 就把包包也一起帶來了。像去喝喜酒,順手把隔壁桌的伴手禮也拿走。
最後選的是 gpt-image-2。不是最新的,但最自然。
不過也不是一律用 GPT。全廳的俯角遠景,Nano Banana Pro 反而最好:
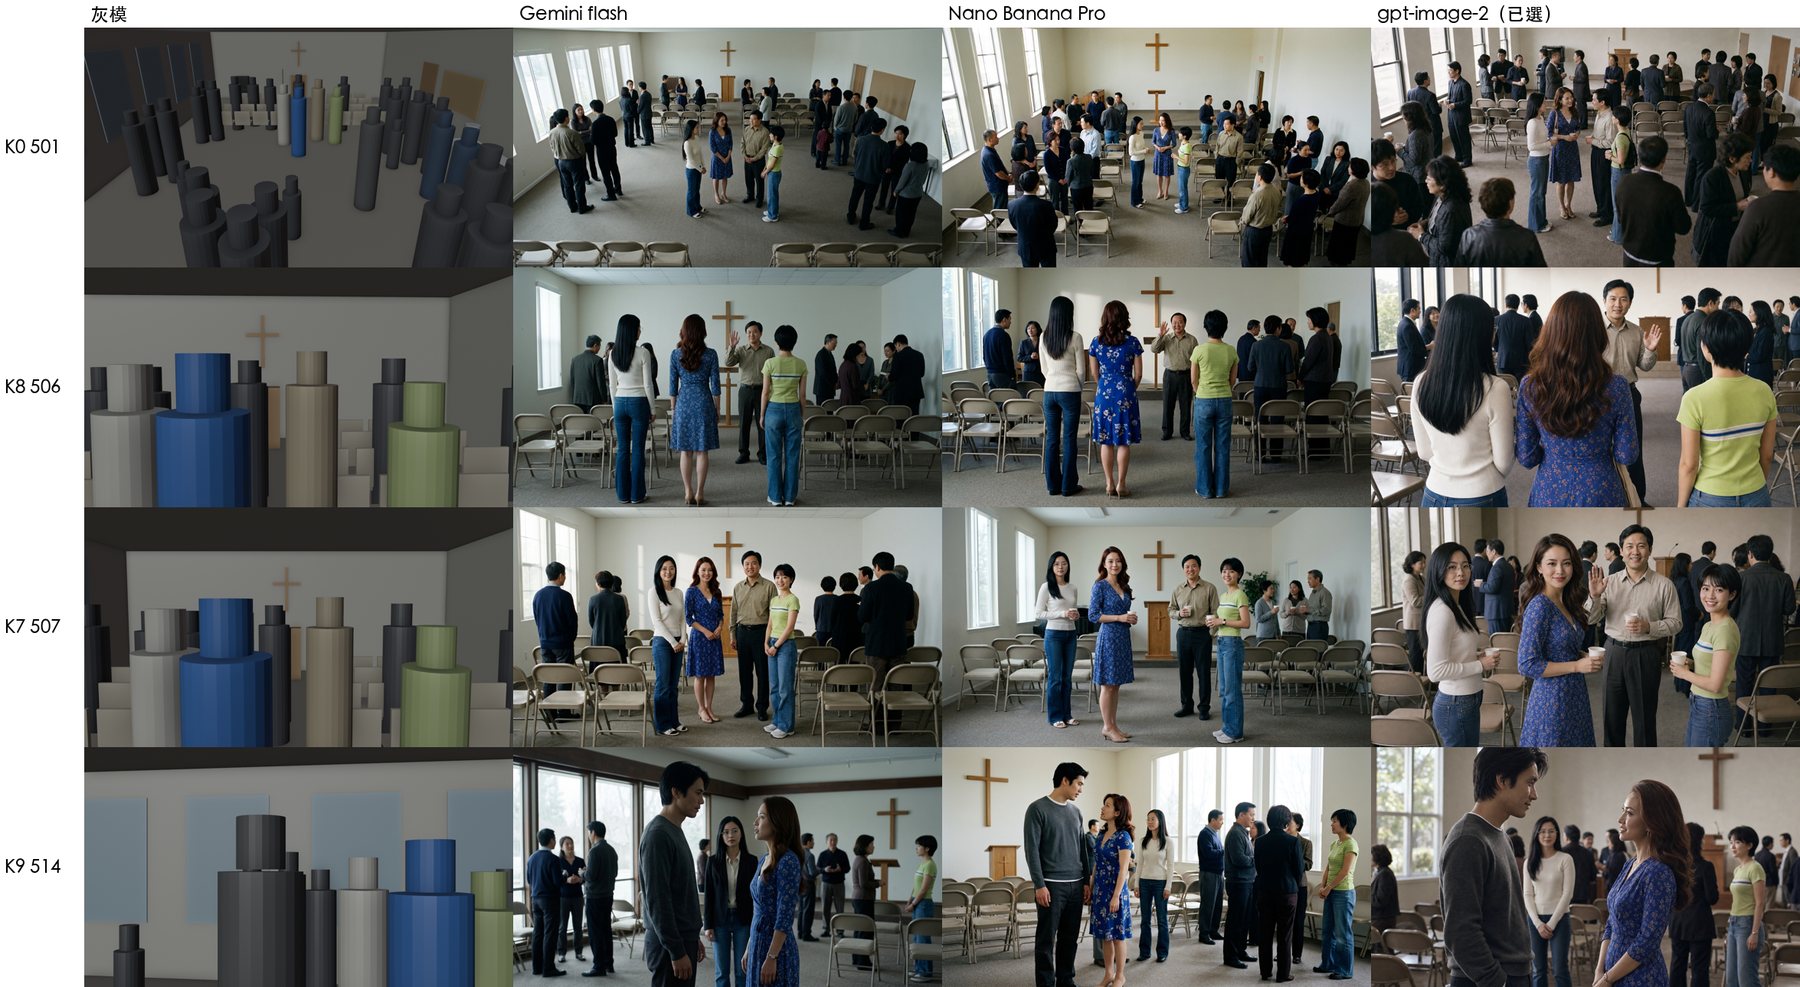
第一列是俯角全景,Nano Banana Pro 最自然;其餘三列要的是近景,GPT 比較好。
⭐ 沒有「最好的模型」,只有「這一格最適合的模型」。 比一次的成本很低,一張板台幣幾塊錢; 板錯了的成本很高 —— 錯的是用到這張板的每一顆鏡頭。
「臉上的光整體不搭」
換臉這一步有個副作用:參考照是棚拍的正面平光,換到一個逆光的房間裡,臉亮得像打了補光燈。
同一段補光指令,我比了五個模型:
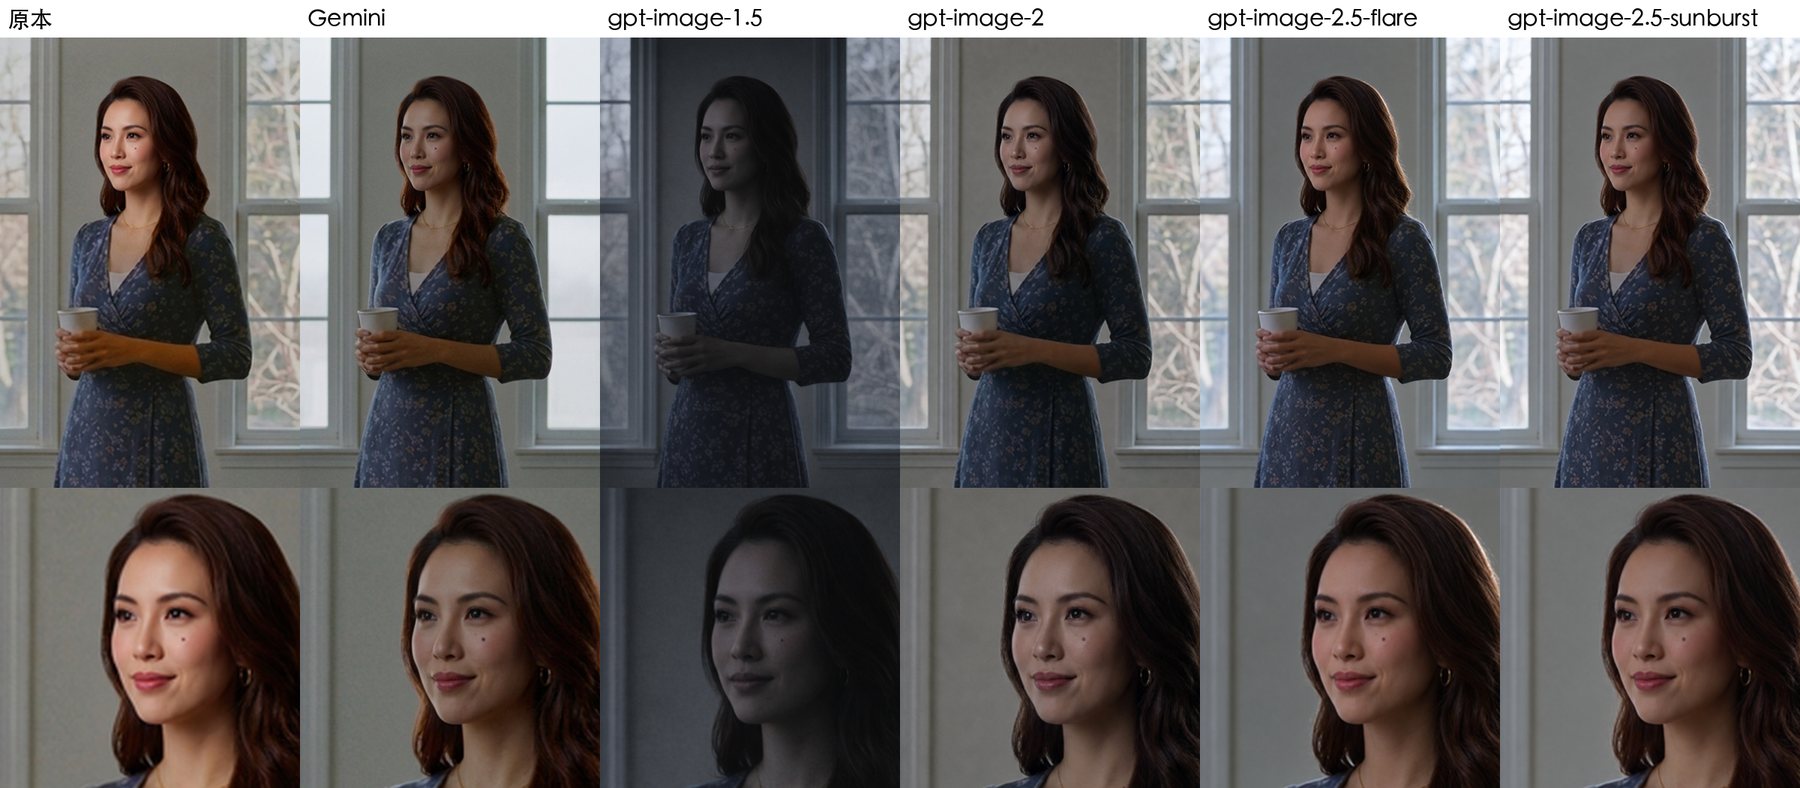
gpt-image-1.5 把整塊都變暗了;gpt-image-2 和兩個 2.5 版本保住了窗戶的亮度,臉也不再像棚拍。這一步我選了 2.5 flare。
有一張板(四個人圍成一圈),我乾脆讓 gpt-image-2 以舊板為底整張重畫,光一次統一:
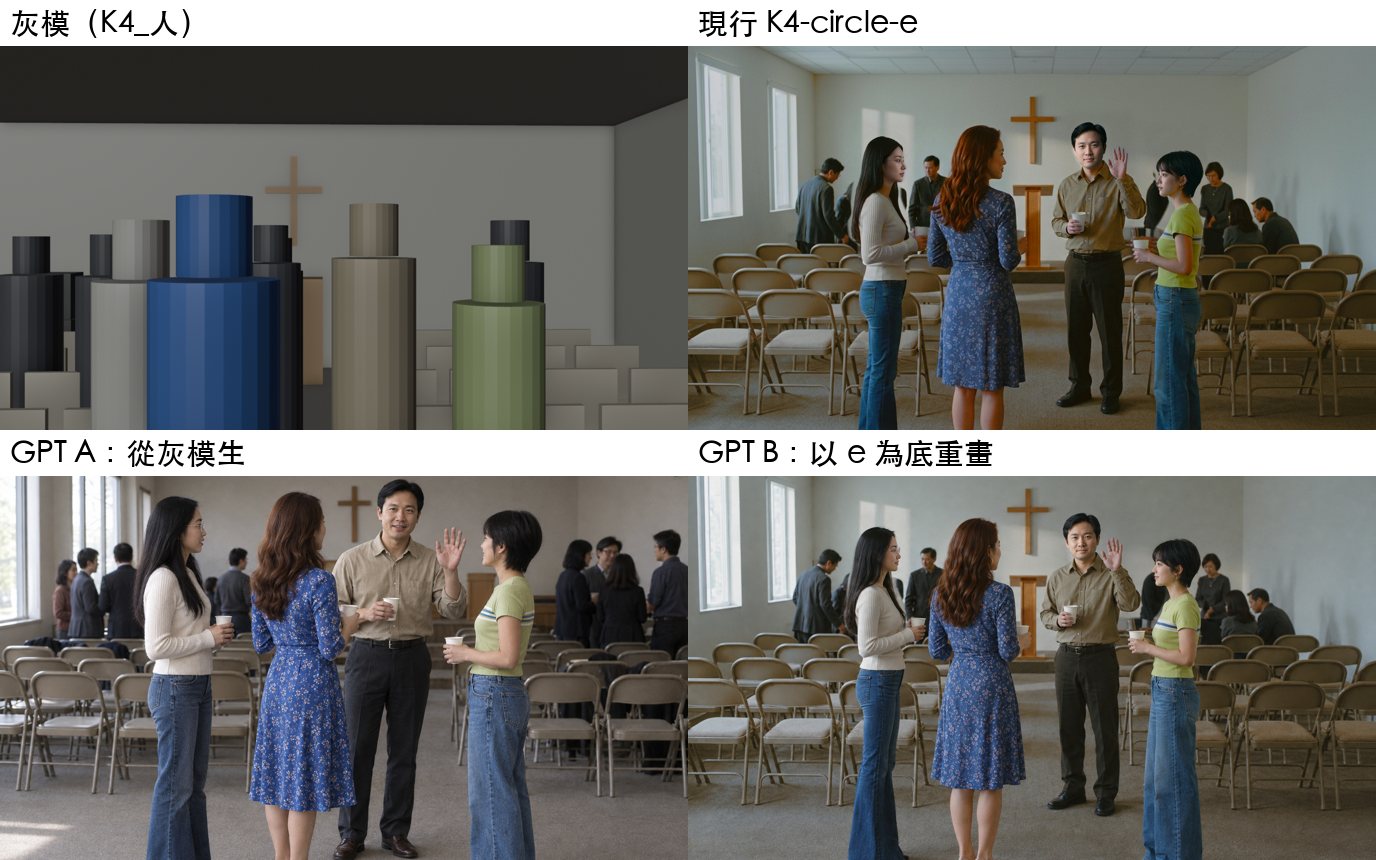
右下是採用的版本。左下是讓 GPT 直接從灰模生 —— 它沒照灰模走,四個人又排成一排了。
「Richard 身穿深灰衣服,506 的背影顏色不對」
這是我這兩天最喜歡的一條筆記。
506 是 Richard 的主觀鏡頭:他走向那一圈人。H3 很貼心地在畫面左前方補了一個肩膀 —— 它覺得既然是某個人在走,那總得有個人。
然後它自己幫 Richard 挑了一件淺藍襯衫。
Richard 這場穿的是炭灰毛衣。但我在 506 的提示詞裡沒寫他,因為我以為他「不在畫面裡」。 模型不會替你想你沒寫的事 —— 但它會替你決定。
所以這兩版差在哪
| 我說 | 真正要改的地方 |
|---|---|
| 遠景的臉慘不忍睹 | 不改提示詞,改板:放大換臉再縮回去 |
| Jenny 太高 | 不跟模型講公分,用程式等比縮放 |
| Jackie 還是太高 | 看的是畫面上的高度,不是身分證上的 |
| 不要點名 | 先回平面圖和灰模,重排機位 |
| image-2 較自然 | 同一組輸入比五個模型,每一格挑適合的 |
| 背影顏色不對 | 畫面裡可能出現的人,都要交代他穿什麼 |
⭐ 左邊是我看片時的直覺,右邊幾乎都不在「寫提示詞」這一格。 第一版我在問「哪個影片模型比較強」,第二版我在問「我給它的第一格對不對」。 後面那個問題便宜得多,而且答得出來。
如果只能帶走一句:
模型不看劇本,它看板。 先把板生對,再來拍。
本文的環境:RunPod 租用之 GPU,MiniMax H3 剪枝 INT8 開源權重, 於 ComfyUI 部署,Ref2VA、8 步 PDD 加速,輸出 1376 × 768。生板用 gpt-image-2(近景)、 Nano Banana Pro(遠景)、gpt-image-2.5-flare(補光)、Gemini flash(局部修改);灰模用 Blender。
每天的進度、失敗與抽格我都貼在脆上:瑞導 —— 那邊是當天的原始紀錄,這裡是想清楚之後的版本。
上一篇寫的是提示詞那一層:〈我說「要有喜感」,模型要的是兩個時間戳〉。 分鏡先於算圖的理由見〈我把上一篇刪掉的那一步,加了回來〉。
本文的 RunPod 連結為推薦連結,透過它註冊我會獲得少量回饋,不影響你的價格。