
Appearance
那張 AI 影片比價表,少了一列
做 5 秒 AI 影片要多少錢:八個方案、一台租來的顯卡,和一個我算錯又改回來的數字
作者:Ray 日期:2026 年 8 月 22 日
社群上流傳一張比價表,整理得很清楚:八個方案,統一用「生成 5 秒影片」計價。 出處是董宇凡的臉書貼文,標題叫「我快要變 AI 比價王了」。
| 平台 | 模型 | 年費 | 720P/支 | 480P/支 |
|---|---|---|---|---|
| 大陸即夢 | Seedance 2.5 | 24,893 | 44.2 | 20.4 |
| 國際即夢 | Seedance 2.5 | 21,419 | 37.7 | 17.4 |
| Higgsfield | Seedance 2.5 Fast | 67,522 | 20 | 10 |
| LibTV | Seedance 2.5 | 57,439 | 16.56 | 7.2 |
| 大陸即夢 | Seedance 2.0 Fast | 24,893 | 8.5 | 不提供 |
| 國際即夢 | Seedance 2.0 Fast | 21,419 | 20.3 | 不提供 |
| Higgsfield | Seedance 2.0 Fast | 67,522 | 11.25 | 5 |
| LibTV | Seedance 2.0 Fast VIP | 57,439 | 7.92 | 3.6 |
(單位新台幣,統計日 2026-08-11,資料整理:董宇凡)
看完我第一個念頭不是「哪個便宜」,是這張表沒有自架那一列。
因為我剛好有數字。
先看清楚這張表在說什麼
每一列有兩個價格,不是一個。
入場費   年付 21,419 到 67,522
單價     每支 3.6 到 44.2
年費是最便宜的那幾格的代價。 LibTV 的 480P 每支 3.6 元,全表最低——但你要先付 57,439。
Higgsfield 的 480P 每支 5 元,年費 67,522,是全表最貴的入場費。
反過來,即夢的年費只要兩萬出頭,但每支 17 到 20 元。
這是一張「先付多少換每支便宜多少」的表,不是一張價目表。
我的數字
過去兩週我在 RunPod 上跑 MiniMax H3,是開源權重、自己在 ComfyUI 部署。這幾筆是實際計時,不是估的。
全部都是 768 × 1376,也就是 1.06 MP ——這件事等一下很重要:
480P 直式   480 × 854   = 0.41 MP
720P 直式   720 × 1280  = 0.92 MP
我跑的      768 × 1376  = 1.06 MP    ← 比 720P 多 15% 像素
2026-08-21 L40S $0.99/hr Ref2VA、20 步
8.0 秒(192 影格) 561.02 秒
9.4 秒(226 影格) 717.25 秒
15.1 秒(362 影格) 1604.30 秒全部都是 Ref2VA。 這件事我一開始沒守住,後來把不同模式的數字剔掉了——原因寫在下一節。
要跟那張表比,得全部換算成 5 秒。而換算需要一個係數。
為什麼只留 Ref2VA 的數字
我原本還有兩筆看起來更漂亮的:RTX 5090 跑 5 秒只要 73 秒,換算下來一支不到一塊錢。
但那筆不能用,有兩個理由。
一、模式不同。 那是 10 步的文字生影片。而我真正要的是 Ref2VA——用參考圖鎖住角色,讓同一個人在不同鏡頭裡還是同一個人。那才是自架的意義,不然直接買 API 更省事。
二、更關鍵:5090 根本跑不了 Ref2VA 的正片長度。
Ref2VA 光權重就要 46 GB,而 5090 在 RunPod 上的容器上限只有 55.88 GiB,剩不到 10 GB 給畫面。328 影格需要 30 GB,直接 OOM。
所以那個「一支不到一塊錢」是一個你實際上用不到的價格。
同樣的理由,我也把「8 步 + turbo LoRA」那筆拿掉了——那是 fl2va 的加速版,Ref2VA 的 turbo 我還沒測。
留下來的只有一台機器、一個模式、一組步數。 數字變少了,但每一筆都能拿去用。
那個係數我算錯了一次
影片生成的成本不是隨長度線性成長——注意力的計算量隨序列長度平方成長,所以片子越長,每一格越貴。
我一開始用 L40S 的三個點去算,得到指數 1.65。
然後我把它拿去外推別台機器,得到一個不合理的結論:一張 $2.12/hr 的卡跟一張 $0.99/hr 的卡一樣快。
不合理的結果通常代表資料有問題。回頭看,果然:
00001   362 影格  1604.30 秒   ← 這是那台機器上的第一支,含載入 46 GB 權重
00002   192 影格   561.02 秒   ← 模型已在記憶體
00003   226 影格   717.25 秒
我拿第一支去算,而它被載入時間灌了水。 灌的是分子,指數就被高估。
只用兩支乾淨的重算:
192 → 226 影格 k = 1.51取 1.5 當工作值。
這件事本身沒什麼了不起,但它是自架才會遇到的:你看得到每一支的計時、看得到哪一支是第一支、知道模型什麼時候被載入。 用 API 的話,你只會拿到一個總價。
換算成 5 秒
用 k = 1.5,匯率抓 32,從 192 影格那筆往下推:
561.02 秒 × (124/192)^1.5  ≈  290 秒
290 秒 ÷ 3600 × $0.99  =  US$0.080  ≈  NT$2.6
L40S、Ref2VA、20 步、768P,5 秒一支約 NT$2.6。
⚠️ 這是外推值,我沒有真的跑過 5 秒的 L40S。但它是從同一台機器上兩筆乾淨的實測、用自己量出來的係數推的——外推的每一個環節都攤在上面,你可以自己驗算。
跟那張表放在一起——但要比對的欄位
這裡差點被我自己搞錯。
我跑的是 1.06 MP,比 720P 還高。所以要比的是 720P 那一欄,不是最便宜的 480P 那欄。
720P/支              自架(1.06 MP,比 720P 更高)
────────────────      ──────────────────────────
大陸即夢 2.5   44.2      L40S Ref2VA 20 步  NT$2.6
國際即夢 2.5   37.7
Higgsfield 2.5  20
LibTV 2.5      16.56
Higgsfield 2.0  11.25
大陸即夢 2.0     8.5
LibTV 2.0 VIP   7.92     ← 全表 720P 最低
全表 720P 最便宜的是 7.92,還要先付 57,439 的年費。
自架同樣畫質是 2.6,年費零。單價不到三分之一。
而且這還沒往下調。480P 的像素只有我現在的四成,理論上還能再省一半以上——但那我沒測過,所以不寫進表裡。
那損益兩平在哪裡?不存在。 自架同時贏了兩個欄位。
但最乾淨的對照不是那張表
拿自架去比 Seedance,永遠會被問一句:模型不同、畫質不同,怎麼比?
有一個對照沒有這個問題——MiniMax H3 自己就有官方 API。
同一個模型,同一份權重,只差誰的機器:
MiniMax H3 官方 API   768P   $0.08/秒   →  5 秒 $0.40  ≈  NT$12.8
自架 L40S、Ref2VA     768P   20 步       →  5 秒        ≈  NT$2.6
(官方定價 2026-08-16,來源)
而且解析度剛好對上,不是「差不多」:我跑的 768 × 1376 就是 768P,跟官方 API 同一檔。
便宜 4.9 倍。
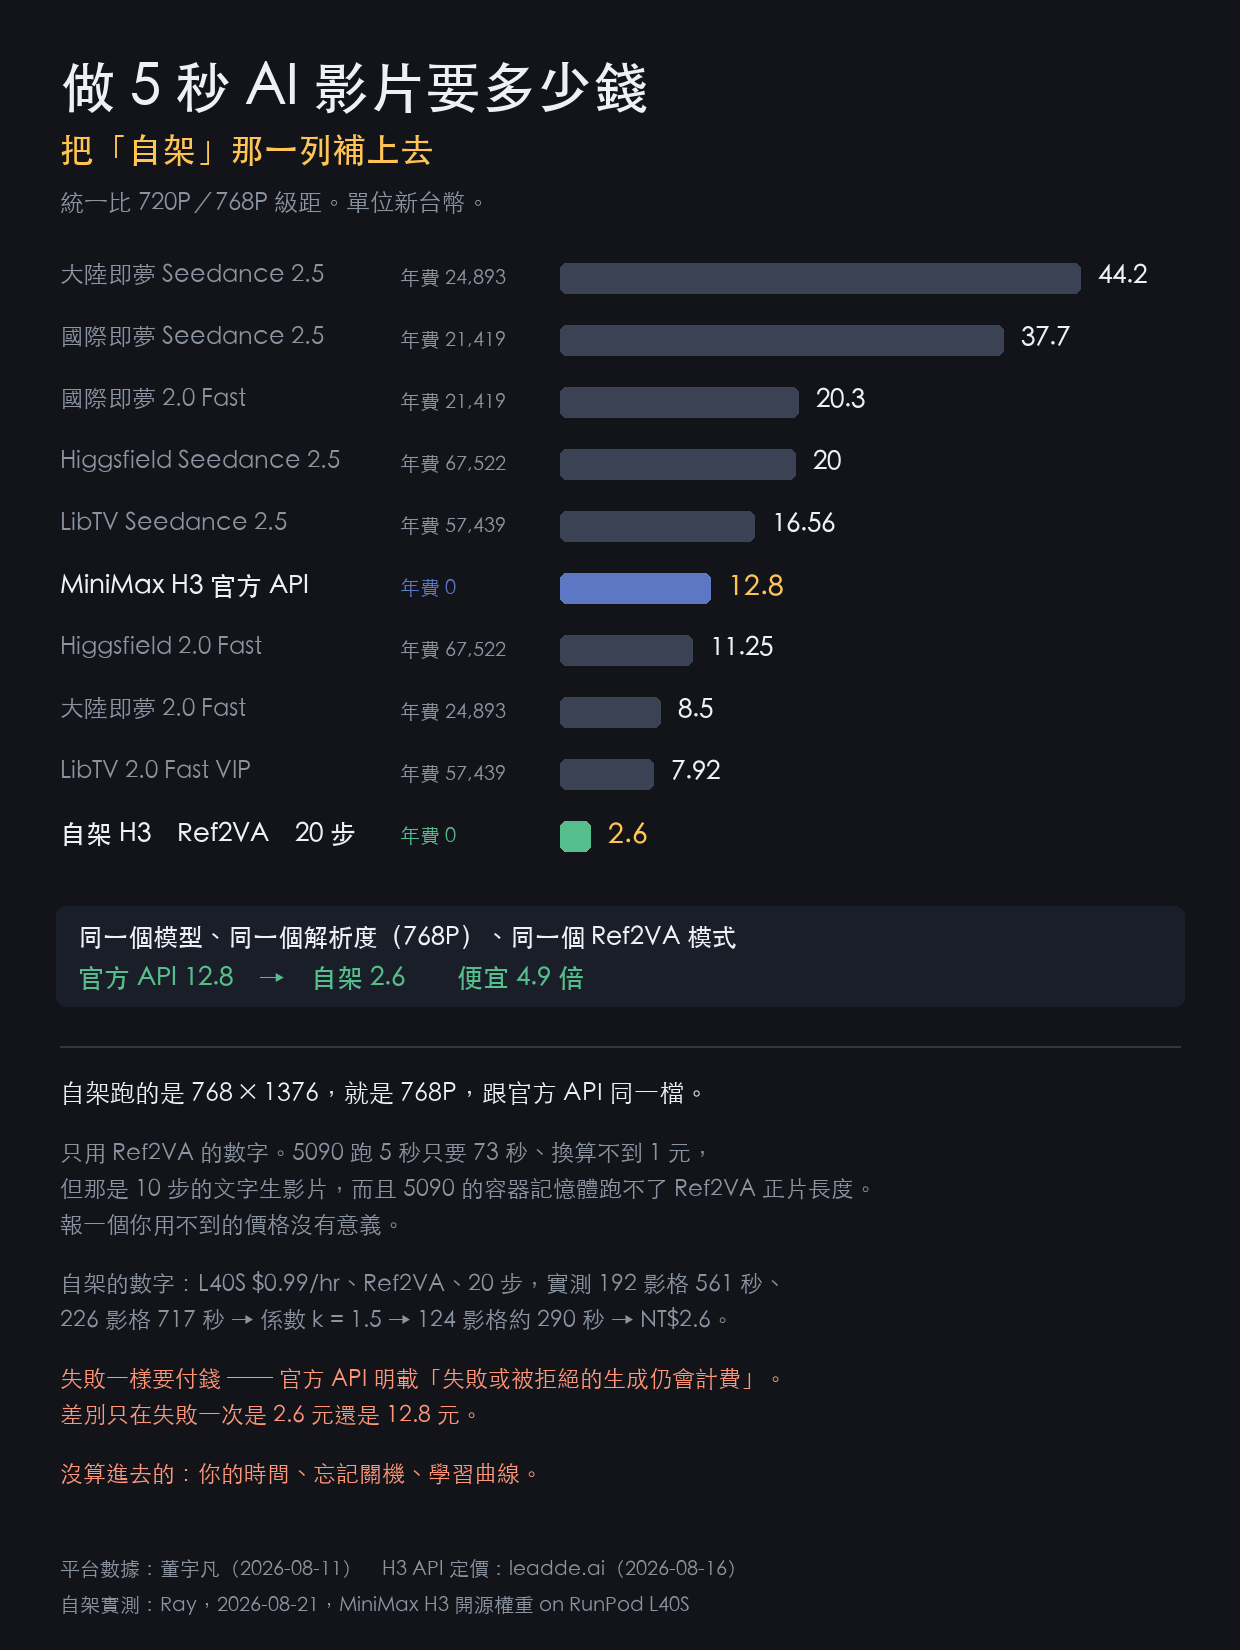
這個結論看起來太漂亮了,所以下面要講它漏掉了什麼。
這個算法沒有算進去的東西
一、失敗率。
上面每一支都是「成功的那一支」的成本。實際上不是每一支都能用。
我這兩天有些鏡頭要跑三到五支才有一支可用——那類鏡頭的真實成本要乘三到五倍。
但這一項對兩邊是公平的。 官方 API 的定價頁自己就寫著:
失敗或被拒絕的生成仍會計費。實際製作成本應按「每部可用影片的成本」而非單純每秒費率計算。
這句話對自架一樣成立。 差別只在於自架失敗一次是 NT$2.6,API 失敗一次是 NT$12.8。
二、你的時間。
租機器要開機、下模型、接工作流、上傳素材。我實測從開新機器到能按下執行,十分鐘以內——其中下載 74.3 GB 只花 1 分 53 秒,瓶頸不在下載,在設定。
十分鐘乘上 $0.99/hr 是 NT$5.3。但那十分鐘你也在,那不是機器的錢。
三、忘記關機。
這是自架真正的風險。那張表上的年費是固定的,你不會多付;一台開著的機器會一直計費。
我這次還踩到一個小坑:RunPod 的 network volume 即使 Pod 關機也繼續計費,$0.015/hr,一個月約 NT$346。
它省下的是每次開機的十分鐘設定。換句話說,一個月開不到十次,那個 volume 就不划算。
四、學習曲線。
這是最大的一項,而且我沒辦法幫你算。
上面那些數字,是我知道要選容器記憶體 133 GiB 的卡、要抓剪枝 INT8 的權重、要把 duration 填 10.8 才會得到 260 影格之後的數字。
第一天不會長這樣。 我第一次租機器的時候,有一整個上午在讀錯的記憶體數字。
選卡:看記憶體,不是看價格
順帶一個實測出來的判準,因為它會直接改變成本。
H3 的權重不放在顯示卡裡,是整份留在系統記憶體,需要的部分才搬進去。所以決定你跑不跑得動的是容器記憶體,不是 VRAM。
RTX 5090      55.88 GiB    328 影格就 OOM
L40S         133.2 GiB    362 影格還有兩倍半餘裕
RTX PRO 6000 175 GiB 充裕而且卡片上標的 RAM 不等於容器上限。L40S 頁面寫 94 GB,實際量到 133.2 GiB,多了四成。開機第一件事是:
bash
cat /sys/fs/cgroup/memory/memory.limit_in_bytes不要用 free -g——容器裡的 free 顯示的是整台實體機,那是鄰居的儀表。
還有一條反直覺的:貴的卡不一定划算。8 月 14 號那次量到,一張 $2.89/hr 的 H100 PCIe 只比 $0.99/hr 的 5090 快 10% 到 30%。
大機器買的是記憶體,不是速度。
8/24 又量了一次,同一個結論,外加一個新的方法論坑
這次租的還是 H100 PCIe,費率 $2.92/hr——跟 8/14 那次的 $2.89/hr 幾乎是同一個數字,兩次獨立量測互相印證。這台機器連續跑了五支正式鏡頭:
00001   328 影格   1225.43 秒
00002   124 影格    397.57 秒
00003   175 影格    527.05 秒
00004   192 影格    560.75 秒
00005   328 影格    944.22 秒
────────────────────────────
合計               3655.02 秒 ≈ 60 分 55 秒 ≈ US$2.97 ≈ NT$95
單看合計,五支正式鏡頭花不到台幣一百元,這本身是好消息。但我原本想順便重算一次 k 值,跟文章前面 L40S 量到的 1.51 對照——算出來的數字完全對不上,在 0.67 到 0.93 之間跳動,而且每次用不同的兩點去配都不一樣。
不合理的結果通常代表資料有問題,這句話我在前面已經講過一次,這次又中了一次。回頭查佇列,果然:這台機器的執行紀錄顯示中途有「3 個進行中」——我在等待渲染的空檔又排了別的工作進去,等於好幾支在同一張卡上搶運算資源。跟 00001 含了權重載入時間是同一類污染,只是這次污染的不是分子(載入時間),而是分母背後的假設(以為每支都是獨占整張卡跑完的)。
所以這五支的計時可以拿來算「這五支花了多少錢」,不能拿來算吞吐量或外推 5 秒單價——跟前面 L40S 那三筆的乾淨程度不是同一個等級。要重新量 H100 PCIe 的乾淨 k 值,得找一段真的只跑一支、不排隊的時間再測一次。
費率本身的結論沒有變,而且被第二次獨立印證了:H100 PCIe 大約是 L40S 的 2.95 倍價格,而這個專案(最長 328 影格)本來就在 L40S 133.2 GiB 的容器上限內綽綽有餘。這次選 H100 沒有記憶體或速度上的正當理由,純粹是多花了三倍的錢。
但這張表真正沒辦法定價的是別的
上面全部都在比每支多少錢。那是這張表的框架,我照著它比了。
可是我這兩天最有價值的發現,一項都不在價格欄裡:
影片模型會照時間戳執行。 你寫「At 00:05.500 切到近景」,它就在 5.5 秒切。我寫一份精確到 0.1 秒、有九個節拍的表演腳本,它九拍全中。
但長度會毀掉這個能力。 同一份腳本,跑 226 影格全中,跑 362 影格全部跳過,而且最後兩秒崩成噪訊。
那個發現值多少錢?它讓我知道表演鏡頭的長度上限。不知道的話,我會反覆重跑一個註定失敗的設定,一次 26 分鐘。
這種東西不會寫在文件裡,也不會出現在 API 的參數列表上。 它只出現在你能改提示詞、能立刻重跑、能看每一支計時的環境裡。
那張表在比「一支多少錢」。自架真正買到的是你知道自己在買什麼。
所以
如果你的用途是「偶爾生幾支,畫質要好,不想碰技術」——那張表是對的,挑一格付錢就好,你省下的時間比省下的錢值錢。
如果你要長期做、要量、要調、要知道為什麼這支不行——
同一個模型、同一個解析度、同一個 Ref2VA 模式,自己跑比官方 API 便宜 4.9 倍。
每支 NT$2.6,年費零。
想自己試一個下午:RunPod。
比價表資料來源:董宇凡的臉書貼文,統計日 2026-08-11。 MiniMax H3 官方 API 定價來源:leadde.ai,2026-08-16。 本文只引用該表作為對照,自架部分的數字全部是我自己的實測。
本文的成本數字全部來自 RunPod 租用之 L40S($0.99/hr)、Ref2VA、20 步、768 × 1376。 記憶體與速度的旁證另有 RTX 5090、RTX PRO 6000 Blackwell 與 H100 PCIe 的實測, 模型為 MiniMax H3 剪枝 INT8 開源權重,於 ComfyUI 部署,輸出一律 768 × 1376(1.06 MP)。 比價表的統計日為 2026-08-11, 我的計時為 2026-08-14 與 08-21。匯率以 32 計。
本文的 RunPod 連結為推薦連結,透過它註冊我會獲得少量回饋,不影響你的價格。